Zmieniaj model lub prompt dopiero po porównaniu obecnej i nowej konfiguracji na tych samych przypadkach, według kryteriów ustalonych przed testem. Osobno sprawdzaj poprawność danych, jakość treści, koszt i czas wykonania. Błąd krytyczny powinien blokować zmianę, nawet jeśli nowa wersja pisze lepiej lub kosztuje mniej.
To właśnie zadanie testów regresji AI: wykryć, czy aktualizacja nie pogarsza zachowania, które wcześniej było poprawne. Nie potrzebujesz do tego konkretnego panelu dostawcy. Początkiem może być plik przypadków, skrypt uruchamiający dwie konfiguracje oraz raport do oceny.
Co właściwie podlega testowi?
Nie testujesz modelu w oderwaniu od procesu. Sprawdzasz konfigurację obejmującą instrukcje, dane wejściowe, ustawienia generowania, dostępne narzędzia i obsługę wyniku. Zmiana sposobu pobierania dokumentów może zepsuć odpowiedź równie skutecznie jak zmiana promptu.
Dokumentacja dobrych praktyk ewaluacji OpenAI wskazuje zmienność odpowiedzi jako powód stosowania ustrukturyzowanych ocen. Zaleca też testowanie rzeczywistego zadania, a nie poleganie wyłącznie na ogólnych benchmarkach modelu.
| Obszar | Co sprawdzasz | Przykładowy problem |
|---|---|---|
| Struktura | Pola, typy danych, dozwolone wartości | Brak identyfikatora produktu |
| Treść | Zgodność ze źródłem i kompletność | Dopisanie niepodanej cechy |
| Przebieg procesu | Narzędzia i przekazanie sprawy pracownikowi | Automatyczna publikacja mimo sprzecznych danych |
| Eksploatacja | Koszt, czas, błędy i ponowienia | Przekroczenie czasu obsługi zadania |
Poprawny JSON nie oznacza poprawnej odpowiedzi. Również dobra odpowiedź nie oznacza poprawnej automatyzacji, jeżeli trafia do niewłaściwego rekordu. Kontrolę pojedynczego zgłoszenia opisuje materiał o porządkowaniu zapytań przed przekazaniem do CRM. Tutaj tę kontrolę rozszerzamy na porównanie całych wersji procesu.
Jak przygotować zestaw przypadków testowych
Zacznij od danych podobnych do tych, które automatyzacja rzeczywiście otrzymuje. Usuń zbędne informacje poufne, a przykłady syntetyczne oznacz jako przygotowane na potrzeby testu. Nie wybieraj wyłącznie wygodnych, kompletnych rekordów.
Przykład hipotetyczny: firma tworzy krótkie opisy produktów z danych dostawcy. Chce sprawdzić tańszą konfigurację, ale nie może dopuścić do dopisywania parametrów. Zestaw powinien obejmować:
- kompletne dane, z których można bezpiecznie przygotować opis;
- brak materiału, wymiarów lub innej istotnej cechy;
- sprzeczność między nazwą produktu a tabelą parametrów;
- nietypowy SKU i znaki wymagające prawidłowego zachowania;
- długi tekst dostawcy zawierający nieistotne fragmenty;
- treść próbującą nakazać modelowi zignorowanie instrukcji;
- przypadki wymagające skierowania rekordu do pracownika.
Dla każdej grupy zapisz, dlaczego jest ważna. Oddziel przypadki typowe od zestawu trudnych sytuacji. W przeciwnym razie jeden łączny wynik może ukryć słabość nowej wersji albo sugerować częstotliwość błędów, której test wcale nie mierzył.
Nie ma uniwersalnej liczby przykładów wystarczającej każdej firmie. Dobierz zakres do różnorodności wejścia i skutków pomyłki. Zostaw też oddzielną część przypadków do końcowego sprawdzenia, której nie używasz podczas poprawiania promptu. Ogranicza to dopasowywanie instrukcji wyłącznie do znanych przykładów.
Dokumentacja pracy z zestawami danych OpenAI opisuje rozwijanie zbioru wraz z kolejnymi iteracjami. W praktyce każdy nowo odkryty typ błędu jest kandydatem do następnego testu regresji.
Opisz warunki akceptacji, nie jedną idealną odpowiedź
Dwa różne opisy produktu mogą być równie poprawne. Porównanie tekstów znak po znaku odrzuciłoby część dobrych odpowiedzi. Lepiej określić warunki, które wynik musi spełnić.
W naszym hipotetycznym procesie mogą to być: zachowanie SKU, wymagane pola, opis oparty wyłącznie na źródle oraz przekazanie do kontroli danych sprzecznych. Długość i styl oceniaj osobno od prawdziwości parametrów.
{
  "case_id": "produkt-brak-materialu",
  "input": {
    "sku": "AB-007",
    "name": "Organizer biurkowy",
    "color": "czarny"
  },
  "expected": {
    "sku": "AB-007",
    "status": "gotowe",
    "must_not_infer": ["material", "dimensions"]
  }
}
To przykładowy zapis przypadku, nie standard dostawcy. Lista must_not_infer opisuje wymagania dla oceniającego. Sama jej obecność nie sprawi, że skrypt rozpozna wszystkie sposoby dopisania materiału czy wymiarów.
Przed uruchomieniem testu ustal również wagę błędów. Przykładowa reguła biznesowa: wymyślony parametr, zmieniony SKU lub pominięcie obowiązkowej kontroli człowieka to błędy krytyczne. Niezręczne zdanie jest problemem redakcyjnym. Nie należy kompensować jednego drugim w średniej punktowej.
Co sprawdzi Python, a co powinien ocenić pracownik?
Python dobrze nadaje się do powtarzalnych kontroli technicznych: parsowania JSON, walidacji schematu, porównania identyfikatorów, sprawdzenia dozwolonych statusów i zapisania pomiarów. Reguły powinny działać jednakowo dla obu konfiguracji.
Pracownik oceniający treść powinien widzieć wejście, wynik oraz kryteria. Sprawdza, czy twierdzenia mają oparcie w danych, czy nie pominięto ważnego zastrzeżenia i czy opis nadaje się do zaplanowanego zastosowania. Warto zapisywać konkretny fragment odpowiedzi oraz powód odrzucenia, zamiast samego „źle”.
Poniższy przykład pokazuje wyłącznie fragment kontroli struktury. Nie wywołuje API i nie ocenia zgodności znaczeniowej:
def validate_output(result, expected):
    if not isinstance(result, dict):
        return ["wynik_nie_jest_obiektem"]

    errors = []
    required = {"sku", "description", "status"}
    if not required.issubset(result):
        errors.append("brak_wymaganych_pol")
    if result.get("sku") != expected["sku"]:
        errors.append("zmienione_sku")
    if result.get("status") not in {"gotowe", "do_kontroli"}:
        errors.append("niedozwolony_status")
    if not isinstance(result.get("description"), str):
        errors.append("nieprawidlowy_typ_opisu")
    return errors
Błąd parsowania, brak odpowiedzi i przekroczenie czasu również muszą trafić do raportu. Nie usuwaj takich prób z obliczeń tylko dlatego, że nie powstał tekst do oceny.
Model oceniający może później pomóc przy większym zbiorze, ale nie jest bezbłędnym sędzią. OpenAI w zaleceniach dotyczących ewaluacji podkreśla potrzebę sprawdzania zgodności automatycznych ocen z ocenami ludzi. Najpierw dopracuj kryteria na wspólnie ocenionej próbce. Jeżeli pracownicy różnie rozumieją regułę, dodanie kolejnego modelu nie rozwiąże tego problemu.
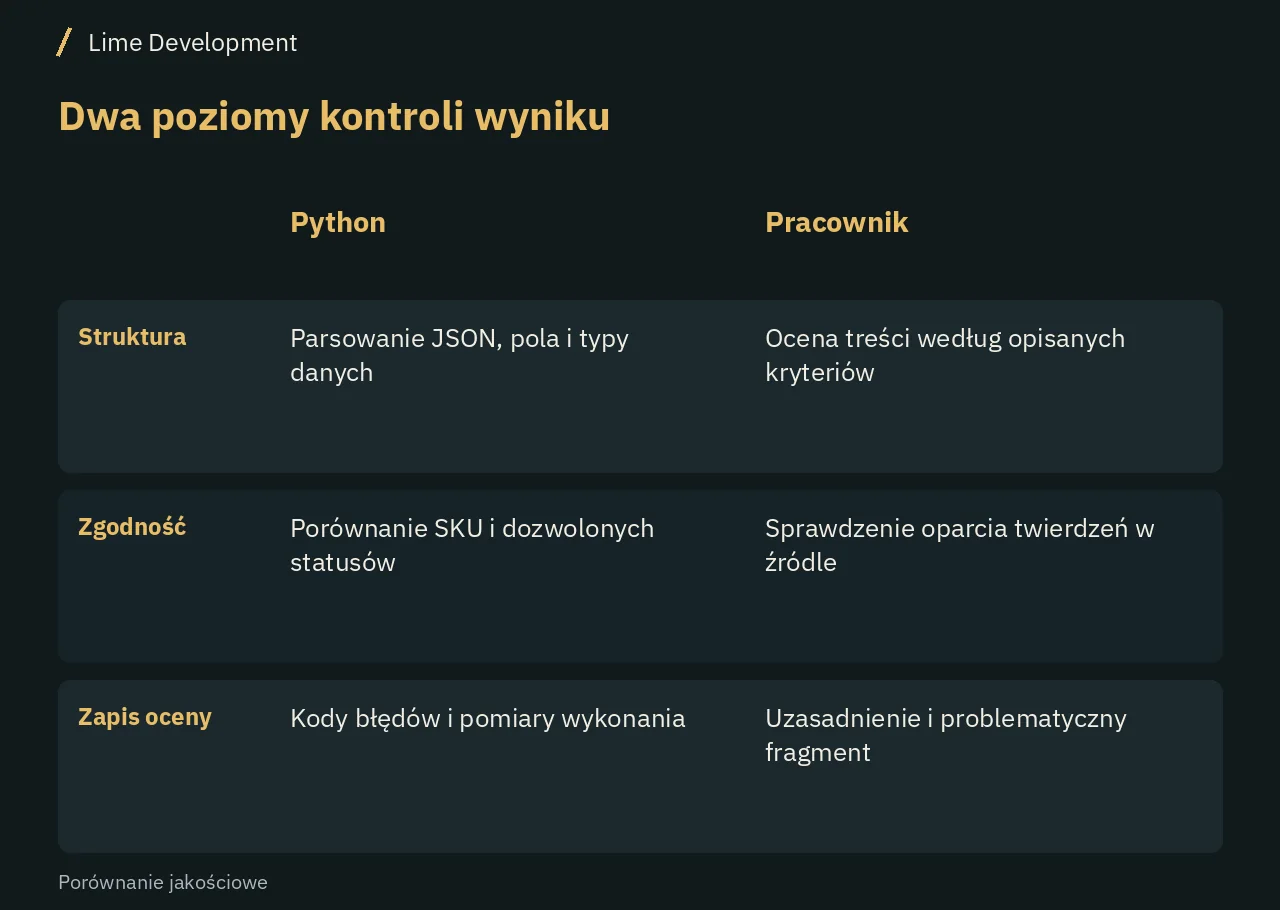
Treść grafiki
| Cecha | Python | Pracownik |
|---|---|---|
| Struktura | Parsowanie JSON, pola i typy danych | Ocena treści według opisanych kryteriów |
| Zgodność | Porównanie SKU i dozwolonych statusów | Sprawdzenie oparcia twierdzeń w źródle |
| Zapis oceny | Kody błędów i pomiary wykonania | Uzasadnienie i problematyczny fragment |
Jak uczciwie porównać obecną i nową konfigurację
Zamroź zestaw danych oraz kryteria na czas jednego porównania. Zapisz wersję kodu, treść lub identyfikator promptu, identyfikator modelu, ustawienia generowania, konfigurację narzędzi i wersję materiałów źródłowych. Nie zapisuj sekretów ani kluczy API.
- Uruchom obecną wersję. To punkt odniesienia, a nie domyślnie bezbłędny wzorzec.
- Uruchom nową wersję na tych samych wejściach. Zachowaj porównywalne warunki i te same zasady ponawiania prób.
- Wykonaj zaplanowane powtórzenia. Jedna udana odpowiedź nie pokazuje stabilności zachowania.
- Zastosuj wspólne walidatory i ocenę treści. Jeśli to możliwe, ukryj przed oceniającym nazwę konfiguracji.
- Porównaj wyniki parami. Ustal, które przypadki poprawiono, a które przestały przechodzić.
Najłatwiej wyjaśnić wynik, gdy zmieniasz jeden element naraz. Jeżeli jednocześnie wymieniasz model, prompt i wyszukiwanie dokumentów, nadal możesz ocenić całą konfigurację, ale trudniej ustalić przyczynę regresji.
Test nie powinien publikować opisów ani modyfikować produkcyjnego CRM. Zastąp działania zapisujące danymi testowymi lub kontrolowanymi atrapami. Gdy zmieniasz całą integrację, dodaj osobny test wykonania narzędzi w środowisku testowym. Samo porównanie odpowiedzi modelu tego nie zastąpi.
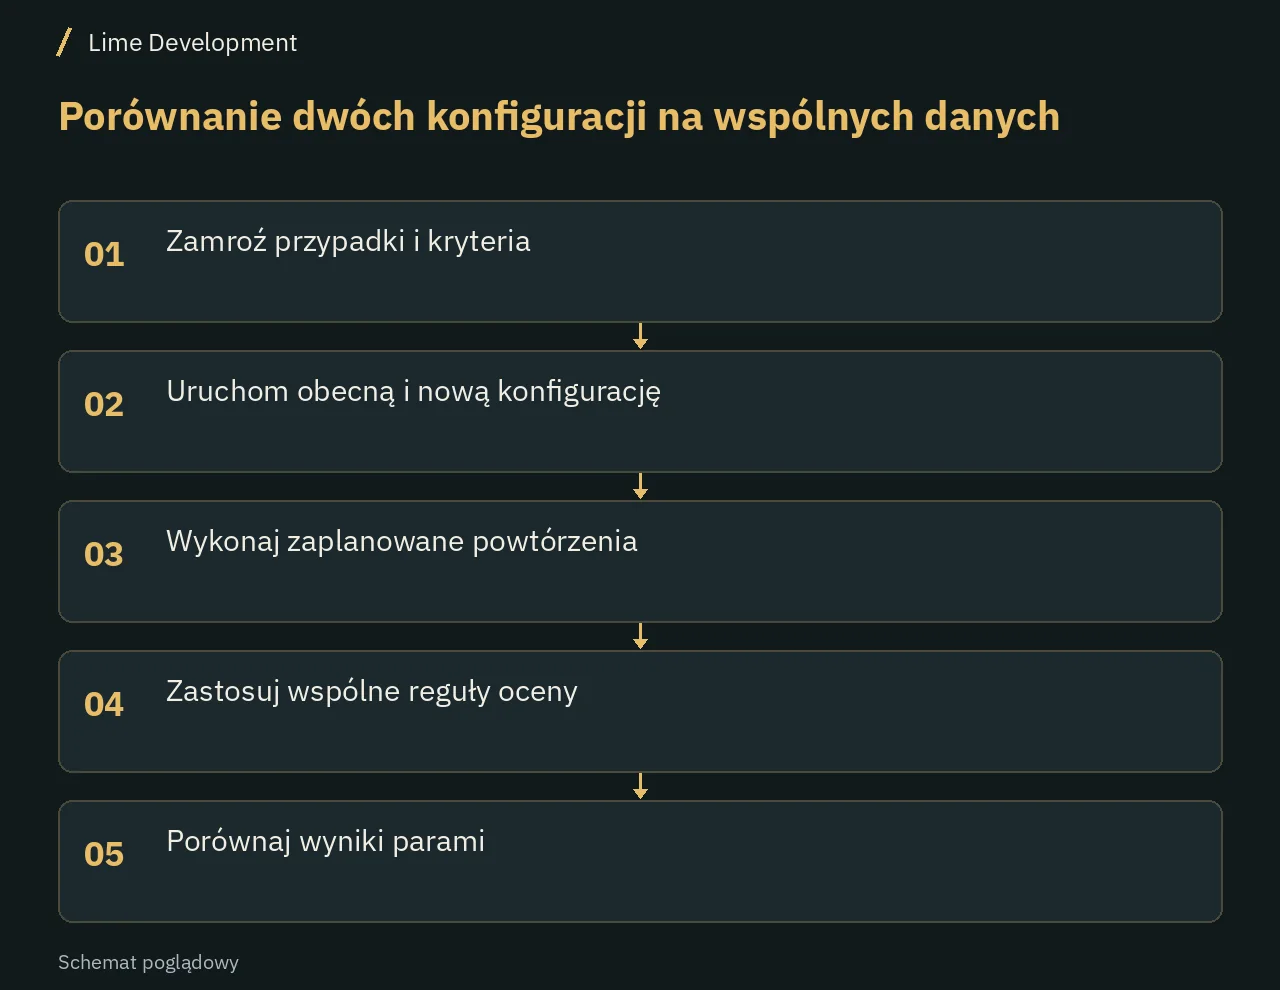
Treść grafiki
- Zamroź przypadki i kryteria
- Uruchom obecną i nową konfigurację
- Wykonaj zaplanowane powtórzenia
- Zastosuj wspólne reguły oceny
- Porównaj wyniki parami
Jak mierzyć koszt i czas bez mylących skrótów
Liczbę planowanych generowań oszacujesz jako: liczba przypadków × liczba konfiguracji × liczba powtórzeń. To nie jest jeszcze koszt. Odpowiedzi mogą mieć różną długość, uruchamiać narzędzia i wymagać ponowień.
Cennik OpenAI API rozdziela opłaty za tokeny wejściowe i wyjściowe oraz uwzględnia koszty wybranych narzędzi. Dlatego raportuj rzeczywiste zużycie, zastosowane stawki i datę kalkulacji. Osobno ujmij koszt modelu oceniającego oraz pracę człowieka.
Mierz zarówno czas samego wywołania, jak i czas całego zadania: z kolejką, narzędziami, walidacją i ponowieniami. Obok mediany pokaż wolniejsze wykonania, na przykład 95. percentyl, jeśli liczba prób pozwala go sensownie interpretować. Przy małej próbce lepiej przedstawić konkretne czasy niż sugerować dużą precyzję.
Kontroluj również warunki pomiaru: współbieżność, limity API i wykorzystanie pamięci podręcznej. W materiale o prompt cachingu i kosztach API opisujemy, dlaczego koszt wspólnego kontekstu trzeba odróżnić od kosztu całego procesu. Tutaj warto dodatkowo policzyć koszt uzyskania zaakceptowanego wyniku, a nie tylko pojedynczego wywołania.
Raport powinien pokazywać regresje, nie tylko średnią
Jeden wiersz raportu powinien odpowiadać jednemu przypadkowi, konfiguracji i powtórzeniu. Zachowaj identyfikator testu, wynik, błędy walidacji, ocenę treści z uzasadnieniem, czas, zużycie API i koszt. Z surowych wyników przygotuj krótszy raport decyzyjny.
| Obecna wersja | Nowa wersja | Interpretacja |
|---|---|---|
| Poprawna | Poprawna | Zachowane działanie |
| Błędna | Poprawna | Poprawa |
| Poprawna | Błędna | Regresja |
| Błędna | Błędna | Nierozwiązany problem |
W hipotetycznym przykładzie nowa konfiguracja może tworzyć zgrabniejsze opisy, ale dopisywać materiał tam, gdzie dostawca go nie podał. Lepsza ocena stylu nie usuwa tego błędu. Jeśli wcześniej uzgodniono, że dopisanie parametru blokuje wdrożenie, decyzja jest jasna niezależnie od oszczędności.
Raportuj wyniki także według grup: dane kompletne, braki, sprzeczności i próby zmiany instrukcji. Brak błędów krytycznych w zestawie oznacza tylko, że nie zaobserwowano ich w tych próbach. Nie jest dowodem bezbłędności w produkcji.
Wdrożyć, poprawić czy odrzucić zmianę?
Protokół odbioru powinien wskazywać badaną konfigurację, wersję zestawu, kryteria, wykryte problemy i decyzję osoby odpowiedzialnej za proces. Dostępne decyzje to:
- Wdrożyć: spełniono ustalone warunki jakościowe i operacyjne.
- Poprawić i przetestować ponownie: wykryto problem możliwy do usunięcia; kolejny test obejmuje również wcześniej poprawne przypadki.
- Odrzucić zmianę: konfiguracja nie spełnia warunków lub korzyści nie uzasadniają ryzyka i nakładu pracy.
Przed wdrożeniem zachowaj poprzednią konfigurację i sprawdź możliwość jej przywrócenia. Sam powrót do starego promptu nie cofnie już opublikowanych opisów. Dlatego ustal także sposób odnalezienia i poprawienia wyników wytworzonych przez wadliwą wersję.
Po wdrożeniu kontroluj próbkę rzeczywistych wyników, błędy techniczne i udział spraw kierowanych do pracownika. Nowe problemy dopisuj do zestawu regresji. Weryfikację dostarczania zdarzeń i bezpiecznych ponowień zaplanuj oddzielnie, zgodnie z zasadami opisanymi w artykule o webhookach, ponowieniach i kontroli duplikatów.
Do zaplanowania pierwszego testu przygotuj: opis jednego procesu, przykładowe wejścia, obecną konfigurację, proponowaną zmianę, listę błędów niedopuszczalnych oraz ograniczenia kosztu i czasu. Z takim materiałem można już ustalić zakres prac samodzielnie albo podczas konsultacji technologicznej. Celem jest konkretna decyzja o zmianie, nie zebranie jak największej liczby metryk.
Źródła
- https://developers.openai.com/api/docs/guides/evaluation-getting-started
- Evaluation best practices | OpenAI API
- Pricing | OpenAI API
Autor artykułu
Krzysztof Rusak
SEO, treści i praktyczne zastosowania AI. Łączę analizę z projektowaniem narzędzi, które ułatwiają codzienną pracę.
Poznaj autora i jego artykuły ↗